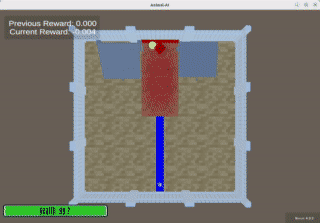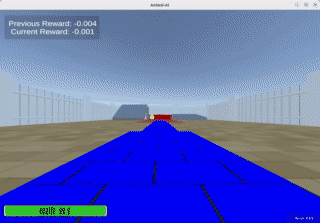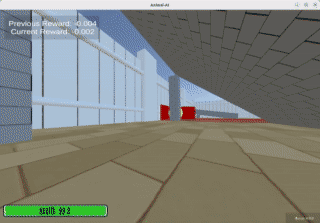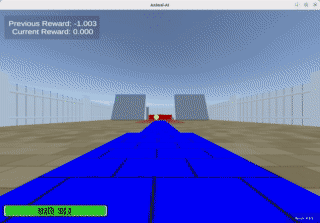
Animal-AI(その8)記憶が必要なタスクでの学習

 高速な適応のためにはエピソード記憶を使った成功/失敗の活用が重要なのではないかと思われます。Animal-AIのような画像入力環境では、画像のトークンも多くなりますし、1エピソードのステップ数も多いので、系列長が大きくなっても推論速度が落ちないことが大事になります。

 とりあえず今回はAttentionではなく状態空間モデル(Gated Delta Net)を使って記憶が必要なタスクを解けることを検証しました。

タスク設定

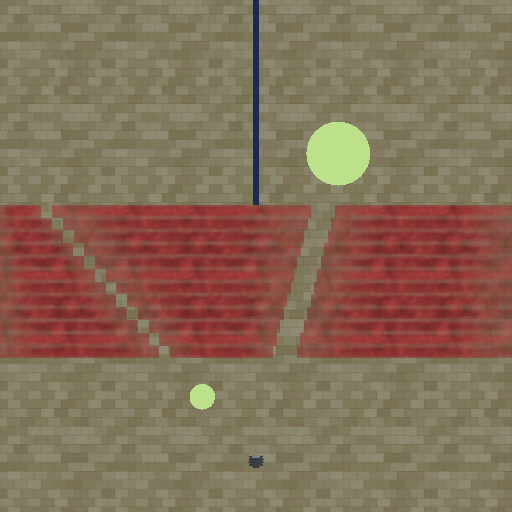
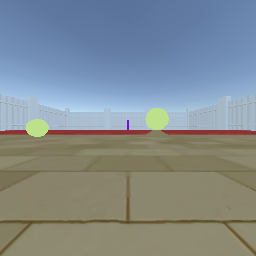
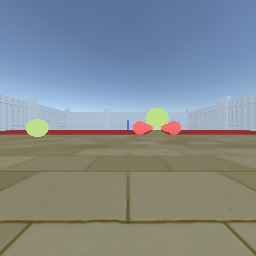
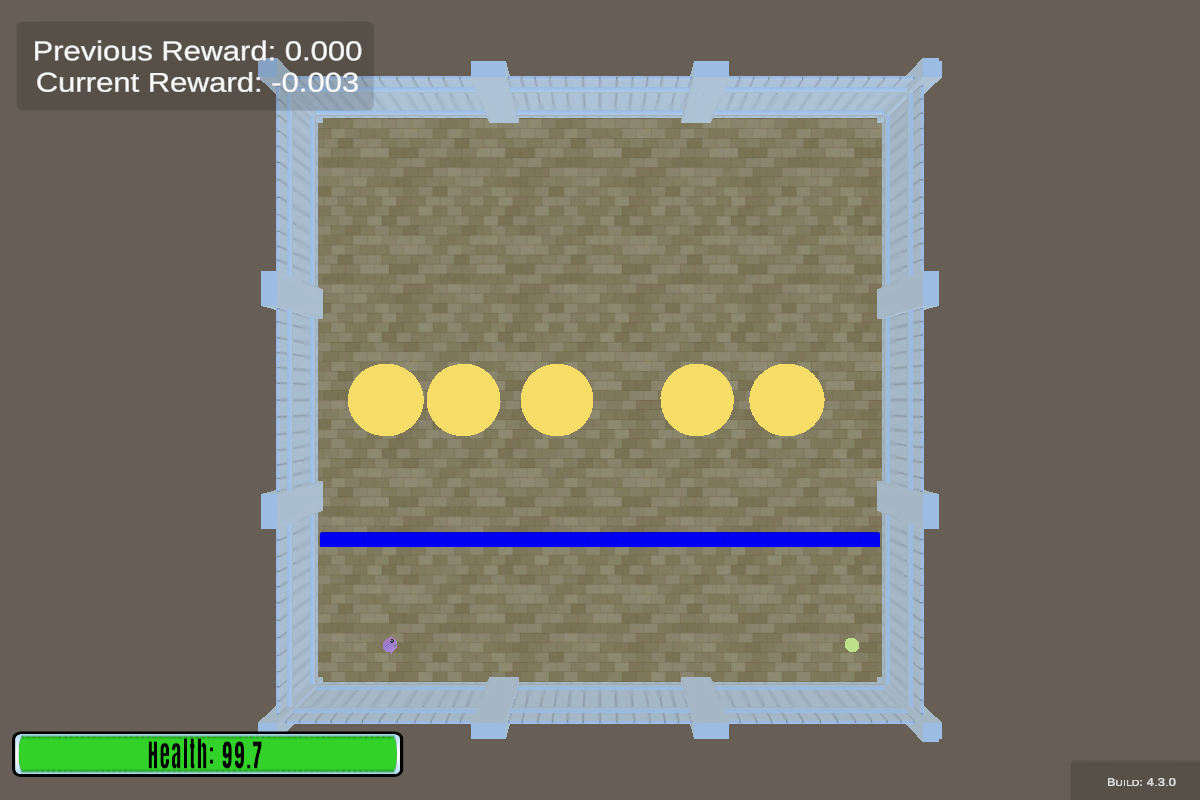
 できるだけ簡単にするため、まずは2種類だけの簡単なタスクを用意します。ステップの最初だけ観測が見えて、それ以降はずっと黒い画面のみが与えられます。

 最初の観測において、(1)右が緑で左が赤 (2)左が緑で右が赤 という2パターンのことがありえます。それだけを見てその後暗転した中、正しい方に触れば成功です。

手法

 各ステップの観測をトークン化し、同じステップの中のトークンは attention で混ぜ、時間方向には少数の register トークンについてGated DeltaNetで時間方向の情報を得ます、オフポリシーの actor-criticを行います。

 また、エピソード境界においてもGDNの状態はリセットせず、学習においてはウィンドウサイズ100で学習を行うため、一応エピソードとしては4エピソードくらいは含まれることになります。

結果

 なんとかチャンスレート50%は超えるくらいにはなりました。

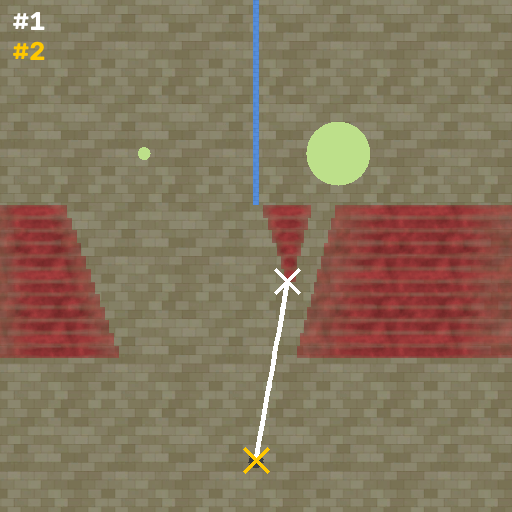
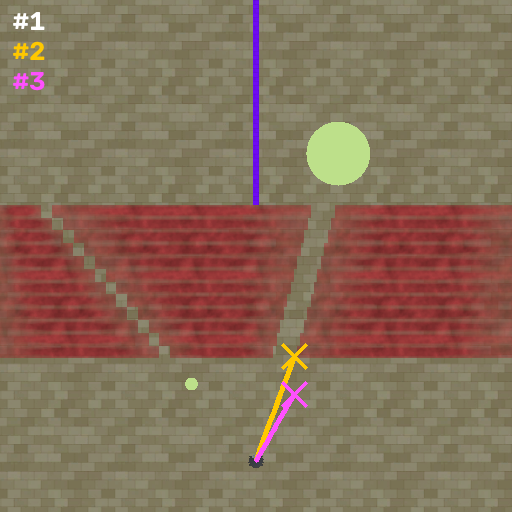
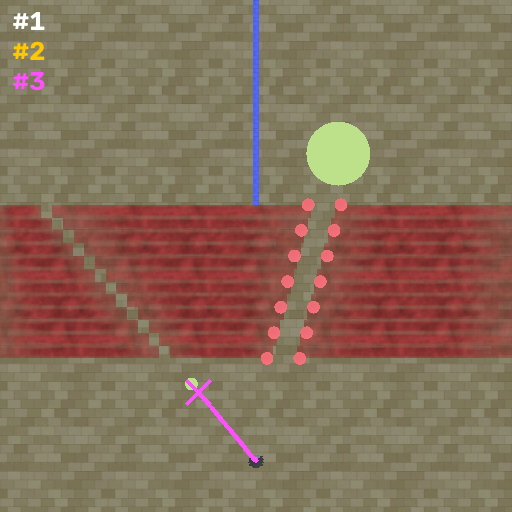
 一方左右のタスクで成功率の差は大きく残っています。これは挙動の違いとしても明確に確認でき、タスクの種類ごとの振る舞いの差を見ると以下のようになっています。

 左側が緑である場合(右下)はある程度素直に到達するような経路になっていますが、右側が緑である場合(左下)では、一度赤い玉に近づいてから謎のルートで右の緑の玉に触るような振る舞いになっています。

 最短の経路を取っていないので、物体の位置関係のような構造を理解しているかというと怪しい気がしますが、まぁ現状ではタスクのバリエーションが少ないのでそれも仕方がないかもしれません。

所感

 成功率が高くなるまでに1200エピソードくらいかかっているため、もう少し早く学習できるようにしていきたいところです。

 また、一般のタスクでも暗転を適宜挟み、一般的な運動制御もしつつ記憶も使っていくことを促進できないか試そうと思っています。

Animal-AI(その7)リスクリターンの異なる2択におけるゼロショットVLM

要約

リスクリターンが異なる2択のようなアリーナを準備し、ゼロショットVLM(Qwen3.8-27B)のプロンプトや反省をいろいろ変えて性能を調べました。

目指していたのは「一度ハイリスク選択肢に挑戦して失敗し、それを受けてローリスク側に選択を変える」というようなことだったのですが、今のところの結果としては、残念ながらそういう変化をもたらすようなタスク設計は見いだせていません。

前提

Animal-AIの画像を見せて、Qwen3.8-27BにReasoningと行動を10ステップごとに1回行わせます。この先の10ステップ分の行動をテキストとして前後移動と左右方向転換の4択に絞って出力させ、決まったルールでパースし、実際の行動とします。公式アリーナのレベル1であれば50%くらいが解けるとわかっています(といっても簡単なものばかりですが)

Animal-AIでは自分のキャラクターの見た目としてハリネズミ、パンダ、ブタの3種類バリエーションがありますが、VLMを混乱させないために、黒いハリネズミに固定します。

タスクを解きやすくするために、ほぼ特権情報ですが、鳥瞰図もエージェントの観測に与えるようにします。

同じタスクは3回連続で試行し、1回エピソードが終わるたびにエピソード全体の画像系列を適当に間引いてVLMに入力し、次回の当該エピソードの開始時のプロンプトとして注意点を出力させます。

試行1: 辺に水平な道

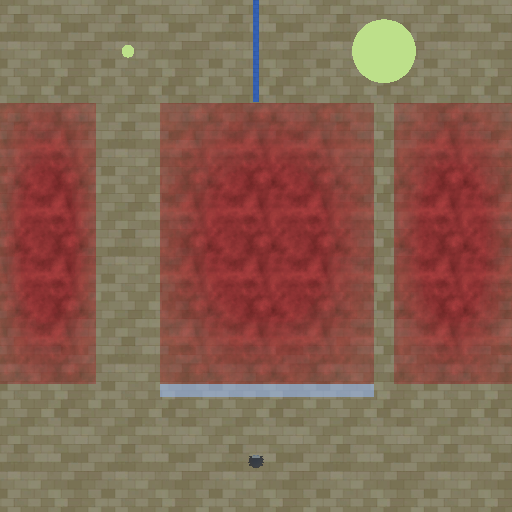
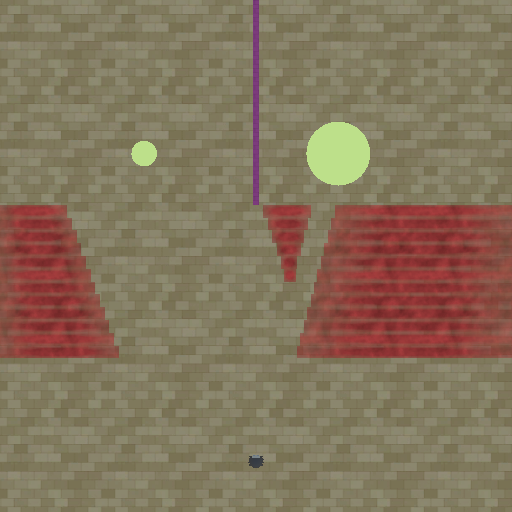
まずは画像のようなアリーナを作成し、

  • 細くてすぐ即死ゾーンに当たるリスクがあるような道の先に大きい報酬
  • 太いため比較的安全な道の先に小さい報酬

があるようなアリーナをいくつか試作して解かせました。

しかし、10通りほど大小の道の幅や報酬の大きさを変えたバリエーションを作っても、どれも解けませんでした。ほぼすべてがスタート地点から動かないか、正面の透明な壁に当たったまま時間切れとなることが多かったようです。

大きな原因としては2つあり、

(1) VLM が同じ行動を繰り返します。たとえばあるシナリオでは 250 ステップのあいだ turn_right だけを返していました。

(2) スタート正面の透明な壁が一人称の画面ではほぼ見えないことでスタックします。即死ゾーンにそのまま突っ込まないためにつけたのですが、これはこれで難しくしてしまっていたようです。

このようなタスク構造だと「斜めに入口へ行き、向きを戻して直進」という 2 段の動きを要し、想定以上に難しいと思われます。

試行2: タスクの簡易化

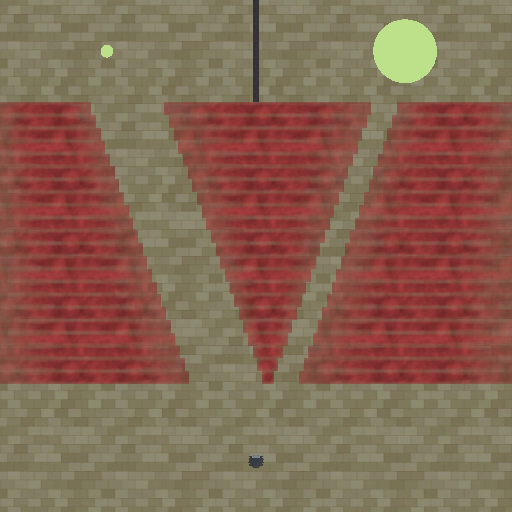
シナリオを修正し、2本の道をスタートから各ゴールへ向かう±20°の斜めの直線にして、透明な壁をなくしました。20°は2ステップの回転(1ステップ10度)でちょうど向けるので、かなり簡単になっています。

また、鳥瞰図を観測に入れたままでは再度同じ行動を取り続けて回り続けたので鳥瞰図は観測から外しました。

こうすることで1回目の試行では10個中1つ、2回目の試行では10個中2つが解けていました。

ただし成功はすべて報酬 5 のハイリスクハイリターン側の道で、あまりリスクを考慮した意思決定にはなっていなさそうでした。振り返りの指示は「ゴールを中央に合わせてまっすぐ進め」「迷うな」といった一般的なものばかりで、道の幅には触れていませんでした。

失敗のうち多かったのは、やはり即死ゾーンの手前で「正面に赤いゾーン」と見て左右の小刻みな回転を繰り返し、前に出られないまま時間切れになるものでした。

試行3: その他各種調整

その他様々な条件での性能を見るためにアリーナに調整を加えました。

ローリスク側を太く

まずはローリスク側をかなり太い道にしました。

これでも小さい球の方に進むことはなく、大きい玉へ向かいました。

典型的な振る舞いとしては、1回目で右の細い道へ向かって失敗し、2 回目は左右に迷ってスタート付近で時間切れということになりました。

振り返り時に(結果・リターン・従った指示)を渡しても内容は改善しませんでした。

ローリスク側の玉を手前に

小さい球(大きさ 2)を即死ゾーンの手前の床にまで持ってきたところ、見た目だけの大きさで、VLM はこれを「大きい方」と判断し、そちらを取るようになりました。

小さい球を大きさ 1 にすると、また大きな方を狙い続けて即死ゾーンに突っ込み続けました。

赤い玉で主観視点をわかりやすくする

細い道の両縁に赤い球を並べると一人称の画面で危険がはっきり見えるようになり、これだと1回目の試行から小さい玉に向かうようになりました。

総括

ここまででは、振り返りによるプロンプト修正によって同じシナリオで狙う対象が変わるという振る舞いは一度も得られていません。

即死ゾーンよりも赤い玉を使って主観視点でわかりやすいようにした方が判断に寄与しそうであったため、そこをもう少し調整してみるとなにか出てくる可能性も少しありそうです。そちらの方がレベル1でのタスクとの親和性もあるため、普通に強化学習したエージェントも含めて挑戦させてみることができそうです。

もう少しその方針で見てみようかと思います。

Temporal Difference Flowsを読んだメモ(Successor Representation)

概要

Successor Representationとは、TD誤差のような形式で構築される次以降の状態分布(あるいはその期待値)を指します。神経科学的にも海馬の場所細胞が似た形式になっているかもしれないという説や、報酬の変化に対して柔軟に対応できる人間の振る舞いに当てはまりが良いモデルとして主張されていたりします(The successor representation in human reinforcement learning)

期待値としての定義をまず確認することにします。

状態の集合  S ,行動の集合  A ,遷移確率  P ,割引率  \gamma から、マルコフ決定過程  \mathcal{M}:= (S, A, P, \gamma) を考えます。ここでは報酬は導入せずとも良く、状態遷移の過程として考えます。割引率はSuccessor Representationの文脈ではエピソードが停止せず継続する確率とも解釈できます。

状態  s ,方策  \pi に対して、  1\lbrack s _ t = s' \rbrack を時刻  t に状態  s' にいれば1、そうでなければ0となる関数とします。Successor Representation  M は次のように定義されます。

 \displaystyle
M(s, s') = \mathbb{E} _ \pi \left\lbrack \sum _ {t=0} ^ \infty \gamma ^ t 1\lbrack s _ t = s' \rbrack \bigg| s _ 0 = s \right\rbrack

これは「  s にいるときに、今後  s' を割引込みでどれだけ訪れるか」を表します。

(性質1) 神経科学の観点では、 状態  s' に対応する場所細胞の現在位置  s での発火率がこの  M(s, s') であるとすると発火パターンの性質を説明できるという説があります。(The hippocampus as a predictive map)

(性質2) 価値関数との接続としては、報酬関数  R があれば  V(s) = \sum _ {s'} M(s, s')R(s') と書くことができます。

生成

生成モデルが発達した昨今ではこのような訪問期待値ではなく、分布を直接生成モデルで学習することがありえます。

ニューラルネットワークによるモデル化としてはγ-modelsやGeometric Horizon Modelsあたりで検証されつつあり、最近ではTemporal Difference Flowsがあります。

Temporal Difference Flowsの論文の方では、生成モデルを使っていくので訪問期待値ではなく分布  m ^ \pi を考えます。

計算の都合もあり、単に分布になっただけでなく以下の変更点が入ります。

  •  m^\pi は  (1-\gamma) を掛けて総和を1に正規化した分布になります
  •  m^\pi は一つ次の時刻から数える(出発点を含まない)のに対し、 M はその時刻から数えます
  •  m^\pi は状態と行動  (s,a) で条件付けられます

ベルマン方程式は以下の通りです。

 \displaystyle
m ^ \pi(\cdot|s, a) = (1-\gamma)P(\cdot|s, a) + \gamma(P^\pi m^\pi)(\cdot|s, a)

右辺の項をそれぞれ解釈すると

  •  P(\cdot|s, a) : 1ステップの遷移確率
  •  (P^\pi m^\pi)(\cdot|s, a) :  (s,a) から次状態に遷移し、そこから  m ^ \pi に従うブートストラップ項

となります。これはTD誤差でのターゲットが  r _ t + \gamma V(s _ {t+1}) であるのとほぼ同じ話です。

Temporal Difference Flowsの論文では、これをFlow Matchingで学習することを考えます。

TD-CFM: 一番素朴に行うと、データセットの遷移  (s, a, s') に含まれる  s' を、 P からの1サンプルとして使い、方策から次状態の行動  a' も使ってモデルの出力を構築してブートストラップに使います。

ただし、これでは学習するときに振り出すノイズと、この次状態での生成のために振り出すノイズが異なる問題があります。

Coupled TD-CFM: こちらでは、上記問題の対策として、そこで同じノイズを使うことで対応関係を保ちます。

TD2-CFM: もう一つの工夫としては、そもそも「生成しきってからまたノイズと混合して教師速度ベクトルを作る」という操作が無駄かつ直線の仮定を導入することになるので、学習する時刻までで生成を止めて、その瞬間のモデルの出力ベクトルをそのまま教師ベクトルとしてしまうというものがあります。

性能としては、直線のFlow Matchingを使っていれば工夫を入れた2つはだいたい同じになるようです。

使い道

学習されたSuccessor Representationの生成モデルを使うと、方策に基づいた訪問分布から状態をサンプリングすることができます。報酬関数に通すと行動価値などの近似ができるので、プランニングのスコアとして活用することができます。

所感

プランニングに使うのも良いといえば良いのですが、プランニングはいつするべきかとかの問題もあってそうそう簡単でもないとは感じます。JEPAとかの表現学習や、推論時にもTD誤差のようなものを考えて不確実性の推定とかに使えないかなという方向が気になるところです。 探してみると、実際にそういうのもあるようですね TD-JEPA: Latent-predictive Representations for Zero-Shot Reinforcement Learning

Reinforcement Learning for Real-Time Vision-Language-Action Policiesを読んだメモ

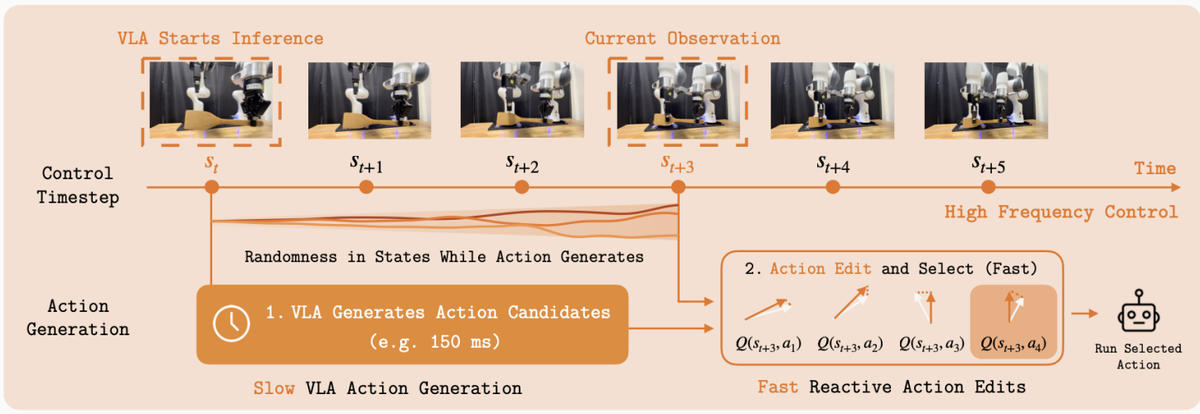
 低速VLA + 高速Edit方策の構成で、かつオンライン強化学習でFine-Tuningする手法が、一連の論文(EXPO, EXPO-FT, そしてこれ)でだいぶ良い形になっているように見えました。

手法

 そもそもVLAは推論に時間がかかるので、行動チャンキングは当然やるとしても長いチャンクを実行していると状況の変化に対応しにくいという問題がありました。なのでEXPOの頃から、高速なEdit方策として、VLAが出した行動チャンクを現在の観測を取り入れながら少しだけ修正していく小さいネットワークを学習するというモチベーションで一連の研究がなされていました。

 Real-Time EXPO-FTでは、実機での遅延分まで考慮して強化学習を行う形になり、実機動作としてはかなり正当な手法になったのではないかと感じます。

 まぁ細かい手法の内容はPDFをChatAIに投げつけて各自読んでいただくのが良いとして、所感みたいなものを残せたらと思います。

所感

 全体としてかなり自分のやりたかったことの一つがやられているという印象で、低速方策と高速方策の枠組み、およびそれを強化学習していく大枠の設計としてはこれを真似すればだいたい上手くいくのではないかと感じます。

 良さそうに思った点を列挙すると

  • SAC的な学習なので一応毎ステップ/毎エピソードの学習予算もコントロールしやすい(とはいえ実行中では学習せずにエピソード終わりにだけで学習トリガーがある)
  • SAC的な学習なのでデモンストレーションや介入データなども自然に混ぜられる
  • VLA部分も学習されている(成功したエピソードでの行動を模倣学習する。Editが入っているので改善になっている)
  • Training-Time RTC も入っている
  • 複数サンプリングした元の行動系列とEditされた行動系列のうち、実際に行うものとして良いものを行動価値で決定する仕組みもある
  • 報酬も変なshapingをしていない
  • コードも公開されている

などになります。

 強いて言えば実験結果がものすごく強い感じではなさそうには見えますが、実機での学習ができていることを考えると優れていると思われます。

 utd_ratio=20というのが結構大きめには見えるでしょうか。サンプル効率のためにはこれが重要なのかもしれません。ただし、前述した通り学習タイミングはエピソード終わりだけのようなので、償却すると大雑把には1ステップに1回分のパラメータ更新にはなりそうです。


 こうなると「認知的にはVLAで解けているが動作が難しい」タスクは結構これでいいのではという気分になってきます。とはいえ、これは事前にVLAとしてある程度良い方策があるのが前提となるため、自分のドメインで行動空間が全然違うとなると大変な部分はあるかもしれません。結局ヒューマノイドが大流行すれば行動空間の違いなんて存在しなくなって、すべて人間体の全身制御という話に集約されるのかもしれませんが。

 最近自分が取り組んでいるAnimal-AIだと、行動空間は前後移動と左右振り向きくらいなので難しくはなく、どちらかといえば認知的な難易度が高いものとなるのかもしれません。Qwen3.8-27BでもReasoning時点で完璧なテキストが出ているかというと怪しいため、そこのVLM部分自体をFine-Tuningして性能を上げるという、とても難しいことをやっていかないといけないのかもしれません。当初の想定ではVLM部分は固定までありえると思っていたのですが……困ったものです。

【断想】連続的意思決定タスクでのVLMとハーネス

 VLMを画像入力の連続的意思決定問題に使っていると、履歴が長くなったときに重くなることが気になります。とはいえ履歴が短いと状況理解の深さに限界があるように感じます。重みが更新されているならともかく、パラメータを凍結してVLMを利用しているだけでは、Animal-AIというおそらく学習データにほとんどなかったであろう世界に対して、理解が深まることなくその場で毎回初見のものとして推論していることになります。

 別の言い方をすれば、ワーキングメモリを超えている記憶、1時間〜1日くらいの長さの記憶に興味があります。Animal-AIでいうと、少なくとも複数のエピソードをまたいだ記憶ということになると思います。常識や意味記憶のような長い記憶であればネットワークのパラメータに埋め込まれると考えて良いとは感じ、また逆にエピソード内部で完結するような数秒程度の短い記憶であればVLMのコンテキストウィンドウに含めることができそうです。その中間くらいの記憶がVLMを各自の環境で使う上では大事になってきて、かつそこから長期記憶への転写という仕組みまでできれば継続的な学習になるのかもしれません。

 この意味での記憶とは内部状態の一種であると思います。以前やっていたストリーミング強化学習で毎ステップ重み更新というのは、ネットワーク全体のパラメータを状態とみなしたいという気持ちの現れでもありました。Fast Weight型のTest-Time Trainingがネットワーク全体に広がったというイメージです。しかし、それはやはり現実的には簡単に上手くいくものではなさそうでした。

 最近のLLMのエージェント的活用を見るには、このあたりの状態はハーネス的なもので管理されていることが多いと思われます。Geminiなどがポケモンをプレイするというのでもそれなりにいろいろなハーネスは使用されており、汎用的に画像環境に適用でき、かつ10Hz程度のリアルタイム動作も維持できるようなものができれば、実践的には十分なのかもしれません。

 ハーネスの作り込みというのはアドホックな対処には見え、データや計算資源を潤沢に用意できるなら余計な仕組みは入れたくないのが自然なのですが、現実的にはそうもいかないのではないかと思い始めています。

 VLMの低速方策と、そのサブ目標を受けて動く高速方策という分離は一定重要だと思います。そして低速方策は低速方策の方でハーネス気味のパラメータ更新は伴わない知識の更新のようなことをやり、高速方策は高速方策の方で従来的強化学習で器用さを向上させていく、みたいな構図を現状では考えています。

AnimalAI(その6)Stage01,02におけるQwen系のゼロショット動作

 前回はAnimal-AIのStage02について簡単なプロンプトで成功率を調査していました。今回はそこからプロンプトや実行方法の工夫を加えて、モデルサイズも広げて調査しました。

やったこと

 モデルのデフォルトのReasoningはオンにするととても長い思考が始まってしまうのでオフにし、代わりに1,2文程度の簡単な状況説明テキストを出力させます。その後、行動をAnimal-AIの9つの離散値で出力させます。形式は前回と同様です。

 前回からの変更点として

  • 前回: 8回に1回VLMで行動を出力させ、8回は選ばれた行動を繰り返す
  • 今回: 8回に1回VLMで行動を出力さて、1~8回から一様ランダムに選んだ回数繰り返し、残りはなにもしない行動とする

としました。これは、左右の振り向きについてランダム性を導入することで「右に振り向く」「左に振り向く」という行動を続けたときに、完全に同じ状態に戻ってまた振り向きループが始まることを防ぐ意図があります。実際、多少は有効に作用していたと思われます。

 重みは差し替えて複数のものを試しますが、どれもプロンプトや動作方法を完全に揃えたので、純粋にモデル性能の比較になっています。

結果

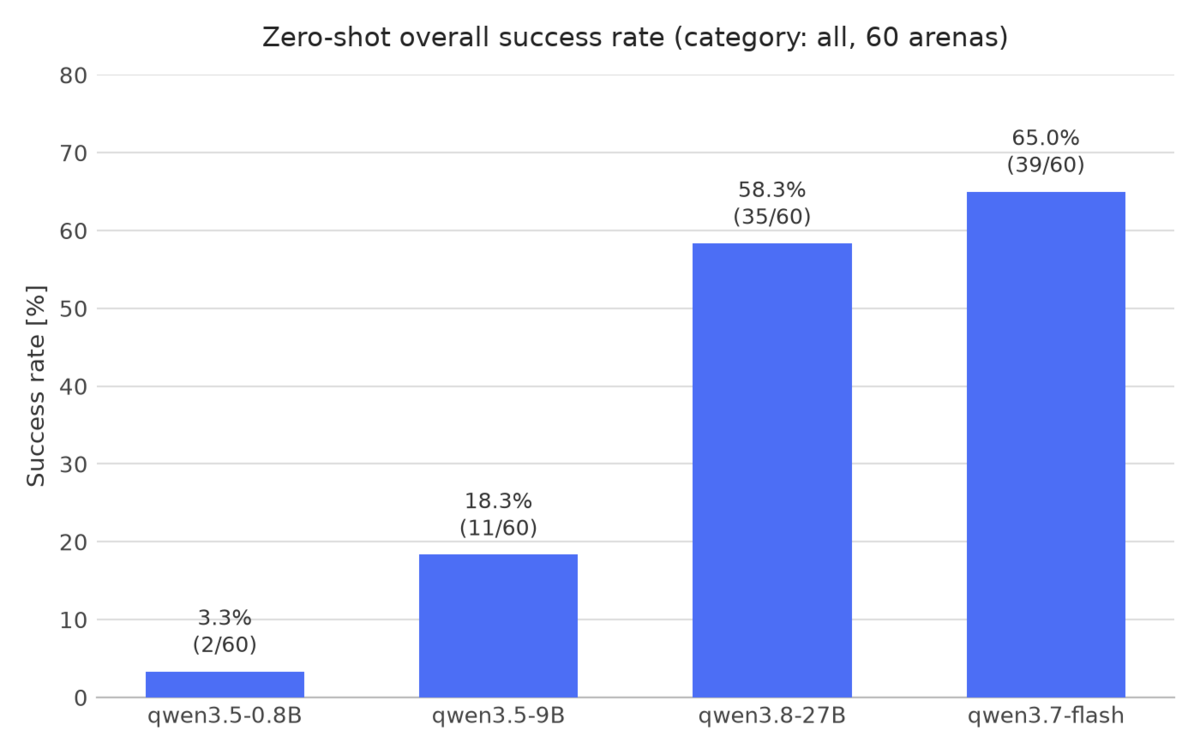
 一番右のQwen3.7-flashはOpenRouter経由のAPIで動かしています。価格はかなり安いので気軽に試行ができたのが良い点でした。結果としてゼロショットで65%ものタスクが解けています。

 右から2番目はQwen3.8-27Bであり、4ビット量子化まですればGPUメモリ使用量25GBくらいで動作が可能であり、5090一枚でも現実的な時間で動きました。

prompt 生成 prefill decode 合計
1813 tok 30 tok 605ms 32ms/tok 1.55s

 結果としても、APIで使うようなモデルに近いレベルまで性能が達しており、これがローカルで動くというのはかなり衝撃が大きいです。

 右から3番目はQwen3.5-9Bであり、かなりガクッと正答率が落ちます。

 右から4番目のQwen3.5-0.8Bは、そもそも行動の出力フォーマットを守れずパース失敗で行動できないことが多く、やはり相当厳しいかなと感じるところです。

 モデルの大きさでハッキリと性能差が出るレベルまで確認できたので、やはり大きなモデルをどう使っていくかという方向になるのではないかと思いました。最も素朴な方針としては、たとえば方策オフ学習をする最初のタイミングでバッファを貯めるための挙動方策として使うなど。LoRAを使ったとして、VLM自体の学習をすることはサイズの観点から難しいかもしれませんが、事前方策としての利用はまだ可能性がありそうに感じられるところです。

 なんとか利用方法を考えていると差分方策的な考え方に吸い込まれてしまいそうで、しかし以前軽く調べた限りでは、あまり良い方法にも思えなかった気がするので、どうするかは悩ましいところです。

AnimalAI(その5)Stage02におけるQwen系のゼロショット動作

 Qwen系の認知能力を調査するために、主に左右の2ルートから適切な方を選択する必要があるStage02においてゼロショット(学習なし)での正答率などを比較しました。

 もともとAnimal-AIは、前後移動(前進・ニュートラル・後退)と左右向き変更(右に向く・ニュートラル・左に向く)の3x3=9通りの離散行動として定義されているので、そのうちの1つをテキストで出力させることで行動決定とします。適切なフォーマットでテキスト出力できていなかった場合、ニュートラルでの出力にします。

実験設定

環境

 Animal-AIの競技用アリーナのうち、Stage02からバリアント01系のもの30個(02-01-01 〜 02-30-01)を1回ずつ使用します。観測画像は256x256サイズとします。

 30個の中でも前半20個(02-01-01 〜 02-20-01)は、正面を見て左右のどちらかにのみ緑の玉が置かれていたり、左右で緑の玉のサイズが違ったりして、どちらか適切な方を選ぶ必要があるタスクになっています。

行動の出力形式

 行動は<move>, <rotation>という語句の対で書かせます。moveはstand still / walk forward / walk backward、rotationはno turn / turn right / turn leftの3通りずつです。

 コードのパースは移動と向きについて順序非依存にしてあります。つまりstand still, turn leftとturn left, stand stillは同じ行動として受け付けますが、turn left, no turnのように両方がrotationである場合は不正としています。不正だった場合は何も実行せず、その区間は静止します。

プロンプト

 システムプロンプトは、環境の説明と行動語彙、そのアリーナのタスク文、出力形式の指示から構成されます。

You control the agent in Animal-AI (first-person view). Find and reach the
green or yellow goal sphere; avoid red zones. Action space: one move and one
rotation, applied on the same tick, written as `<move>, <rotation>`. ...
Face what you are heading for before you close on it: while it sits off to one
side of the view, turn on the spot towards it, and walk forward once it is
centered. You see only what is in front of you while the arena extends all
around you, so what you are looking for is out of view more often than not,
and turning on the spot is how it is found.
What this arena asks of you follows as `Task:`. Task: <アリーナごとの指示>
Reply with exactly two sections and no other text. First, in AT MOST two short
sentences inside <think>...</think>, say what in the current image decides your
next action ... Then output the action inside <answer>...</answer>, which must
contain ONLY the action -- no commentary, no labels.

 毎ステップの入力として、画像に加えて速度・報酬・累積報酬・pass mark・体力・ステップ数を数値で与えています。過去16ターン分の会話(画像と数値、それに対する自分の応答)を履歴として保持します。

推論の頻度

 VLMは16ステップに1回だけ生成し、その間は同じ行動を保持します。エピソード長は最大250ステップなので、1エピソードあたり最大16回の行動決定となります。

モデルと生成条件

項目 設定値
ローカル Qwen3.5-2B / 4B / 9B
API Qwen3.7-flash(OpenRouter経由)
生成長 max_new_tokens: 128、</answer>で打ち切り
温度 0.5
thinkingモード 無効(プロンプト側で<think>を書かせているため、モデル自身の思考は使わない)

結果

 ローカルで動かせるものとしてQwen3.5の2B, 4B, 9Bのサイズを使用し、OpenRouter経由でQwen3.7-flashを使用しました。

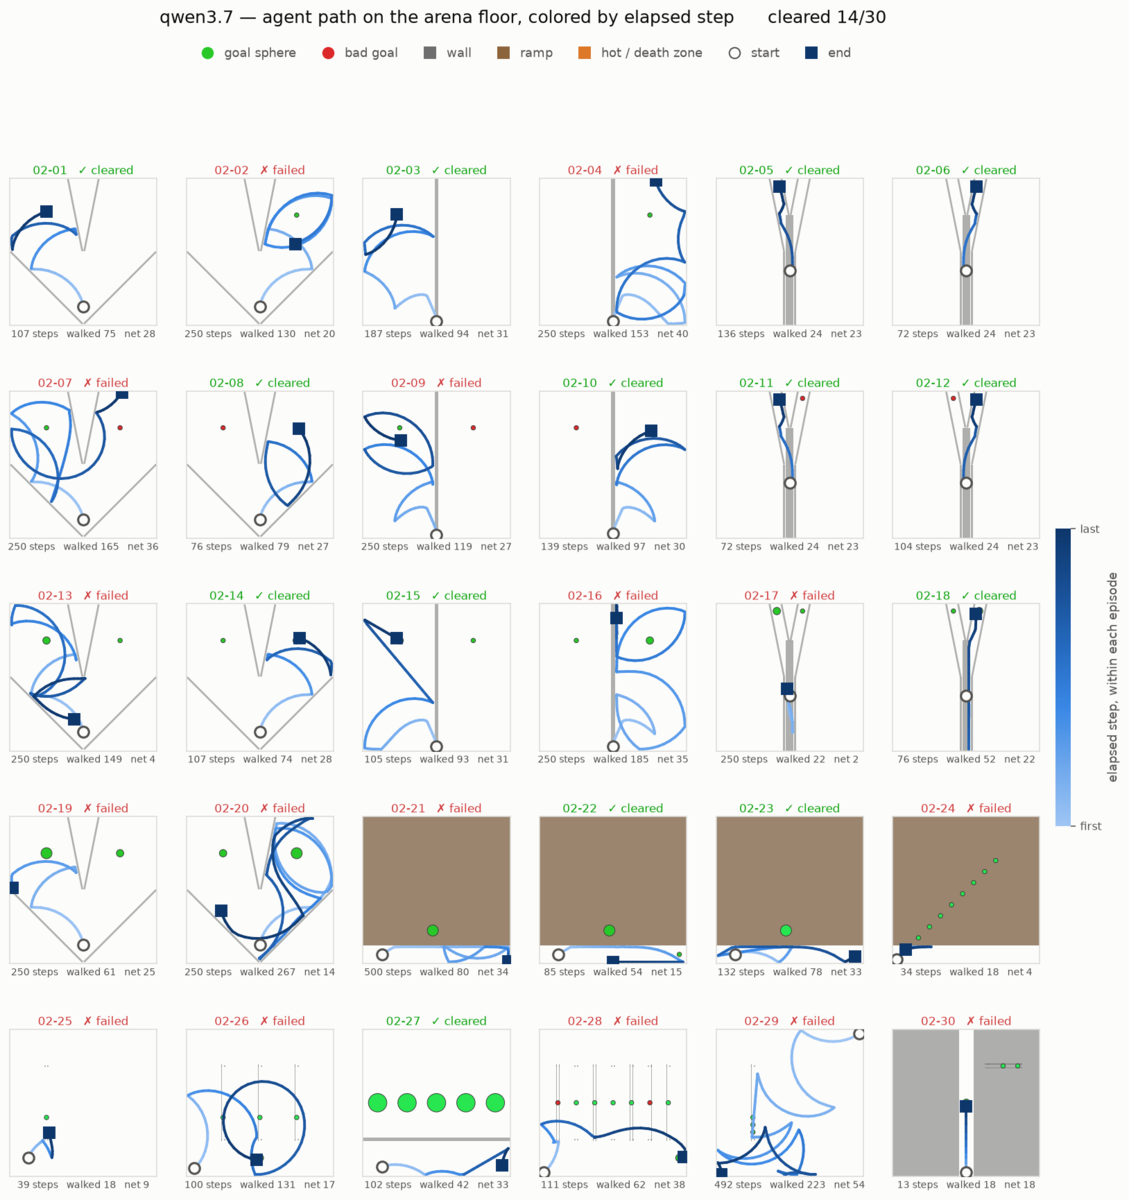
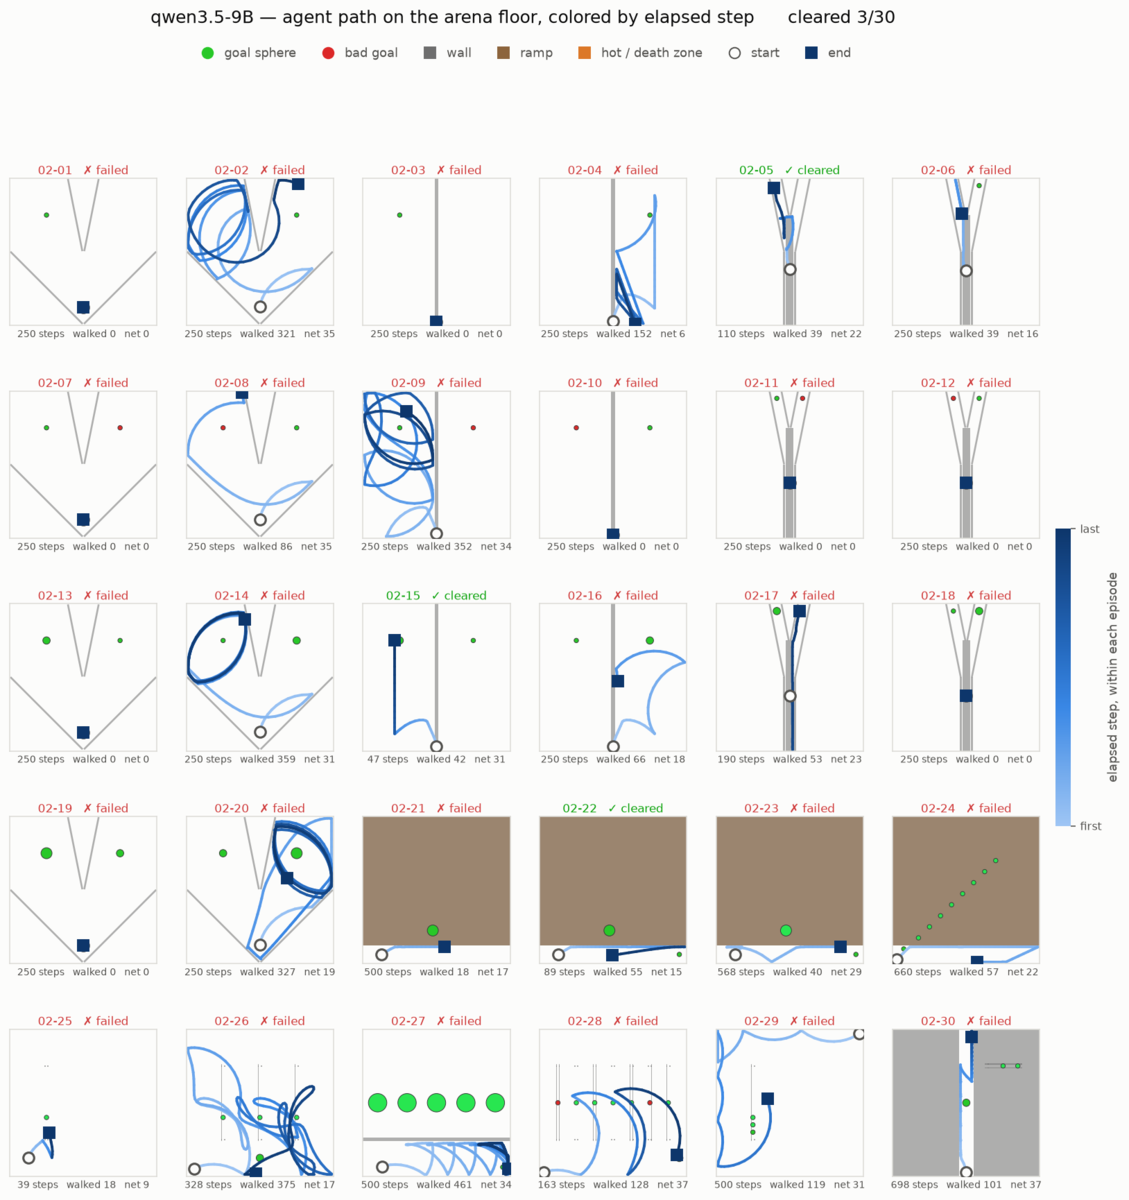
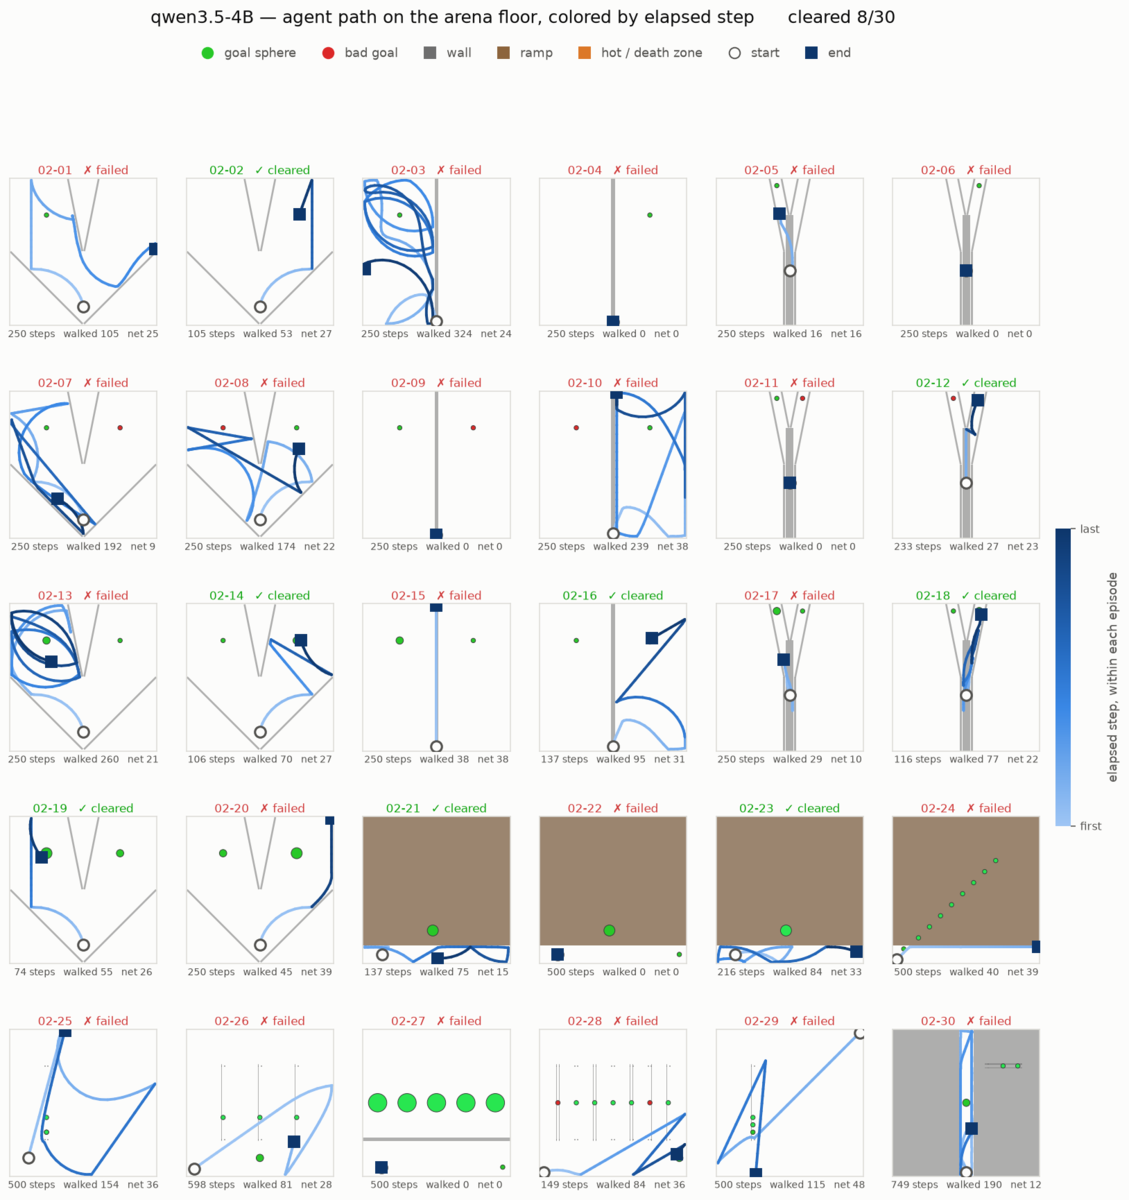
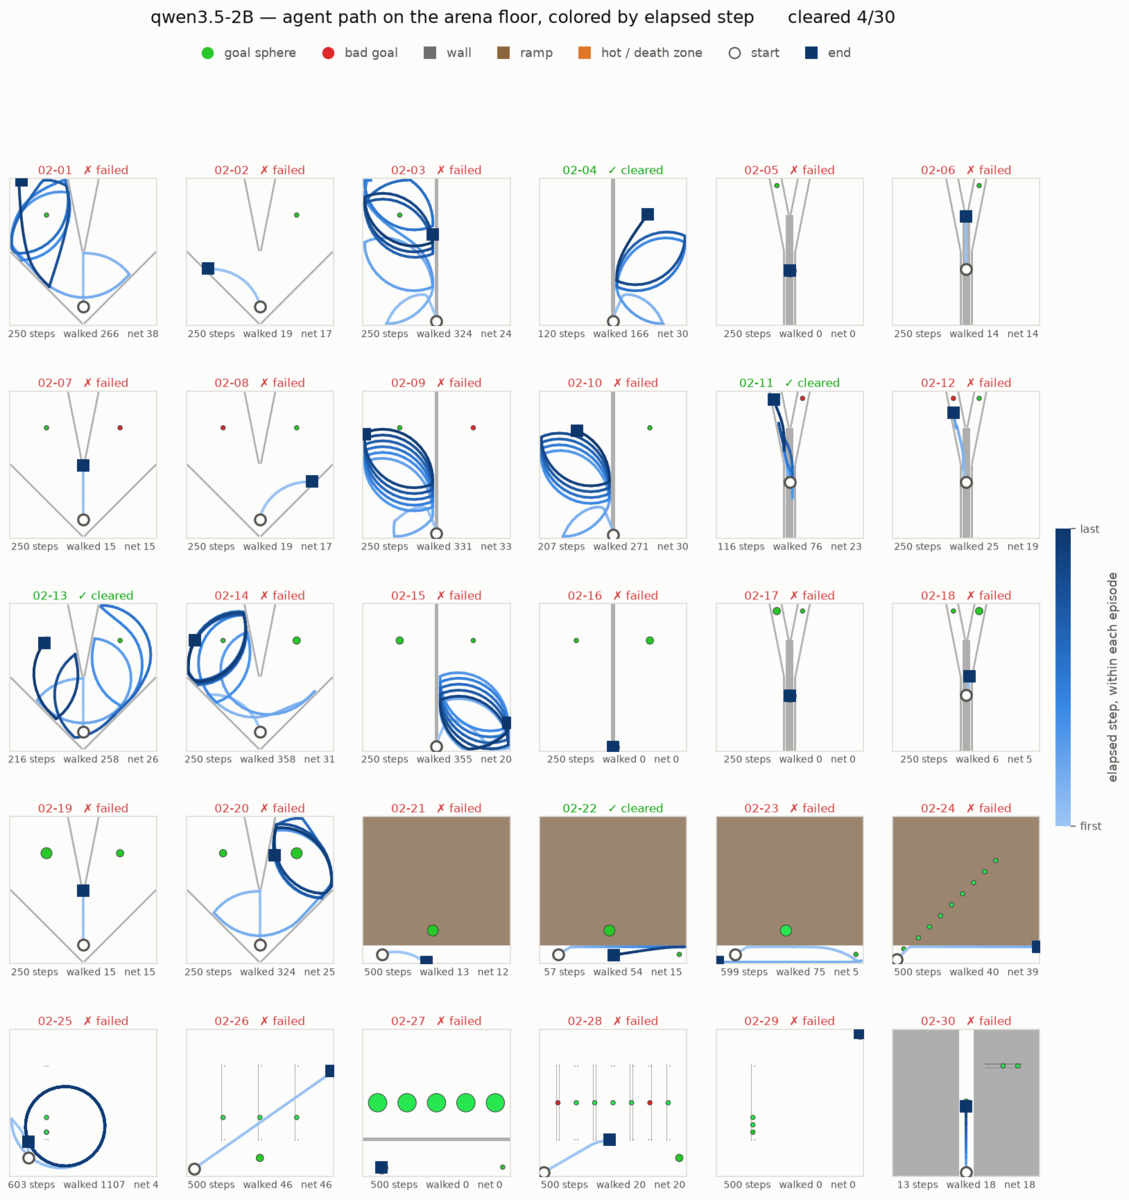
図の見方

 各図は30個のアリーナを1パネルずつ並べたもので、床を真上から見た平面にエージェントの軌跡を描いています。線の色は経過ステップで、薄い青が開始、濃い青が終了です。エピソード長が13〜750ステップと幅があるため、色はエピソードごとに正規化しています。

 背景はアリーナの実際の配置で、エピソードが読み込んだyamlから緑球・黄球・赤球・壁・ランプなどを描いています。パネル下の数字は、エピソード長・移動した総距離・開始から終了までの移動距離です。

Qwen3.7-flash

 こちらでは30通り中14シナリオが解けており、失敗したものも最初に向かう方向としては正しく、16ステップ刻みであるため制御が難しかったと推察されます。

 前半20個が左右から適切なものを選ぶタスクであり、そこから左右の移動方向の正しさだけでカウントすると19/20では最初に良い方向を選べていると判断できます。
Qwen3.5-9B

 9Bでは成功数が3/30とかなり低くなりました。

 テキスト出力を見ていると、

The yellow goal sphere is still on the left, so I must keep turning left to
center it before moving forward. <answer>turn left, no turn</answer>

というように、最後行動としてturnの指示を2つ書いてしまい、不適切ということがたびたび出ています。

 左右の判断自体を細かく確認すると、19/20ではおおよそ正しい方向には進もうとはしていそうでした。フォーマットのエラーを修正すれば良くなるかもしれません。
Qwen3.5-4B

 4Bでは成功数が8/30となっており、失敗している中でも左右の移動判断は悪くなさそうです。最初に行けている方向の判断でカウントすると15/20では正しい方向に行けていて、残り5では左右どちらにも行けていないという状況になっています。このレベルの判断であればいったん4Bサイズでもできるかもしれません。
Qwen3.5-2B

 2Bではでは成功数が4/30となっており、左右最初に進む方向でも失敗があることが気にかかります。最初の20個でカウントすると、6/20程度であり、チャンスレートより低いところまでになっているかもしれません。
まとめ

 やはり基本的には大きいモデルの方が良い性能であることがこのドメインでも確認できそうでした。フォーマットエラーも出るところはあるので、プロンプトの修正や軽く強化学習を入れていくことは試してみたいところです。

JCSS2026参加記

 8/31(月)〜9/2(水)の日程で日本認知科学会第43回大会が行われていました。自分のポスター発表、聴講などの記録を残します。

自分のポスター発表

ストリーミング強化学習による VLA モデルの訓練

 私は修士の頃は、コンピュータ将棋への大会参加が多かった + M2の人工知能学会での発表はコロナによりリモート開催だったため、こういう学会へ現地参加してポスター発表するというのは初めてでした。2時間ほどの時間でしたが、それなりに多くの人に来ていただいて暇になるということはあまりなかったです。

 内容面では、やはりストリーミング強化学習の利点というものがあるとして、それをまだ考えきれていない、詰めきれていないというのは感じました。性能が良いわけではないし、速度面・メモリ面での軽量化も本当に必要に迫られている設定を作り出せているわけでもないため、普通にリプレイバッファ使えば良いだけになってしまっています。もっと巨大なVLMとかを使って、そもそもバッチサイズ16なんて無理だというくらいにしなければいけないのかもしれません。

 またCARLAでの実験もLIBEROでの実験も、まだ結果が弱いので、どうしても微妙な主張になってしまうという点は大きかったと感じます。VLA x RLの分野もプレイヤーは多いので、ここで明確に性能向上を出していかないといけないのは大変なのですが、それをやるための博士課程でもあります。

 そのためには、もっとVLMの言語生成によるChain of Thoughtを動作決定に活かしていく必要があると思っています。どうしても重いので毎ステップではなく非同期的に、かつできれば言語モデル部分も強化学習でFine-Tuningしながら……という方向性を考えたいところです。

オーガナイズドセッション

 各種の認知的振る舞いに関する議題が話されていました。私は人工知能側の研究者なので、これらの挙動をいかにして実装・実現することができるかという点に考えを巡らせながら聞いていました。

夜明け前の認知:違和感ともどかしさの探究 Part-2

 このセッションでは、ある程度の時間の長さにわたって違和感や疑義を抱いた状態から、最終的にひらめきや理解へ至るという心理的状態の変化について話されていました。

 ある瞬間では不確実性の多い内部状態が、なんらかの契機を伴って収束していくという過程として考えると、これを人工知能で表現するなら、やはり(信念)状態の確率分布を考える必要があるのではないかと思いました。そのやり方としては、正規分布などでパラメータを使って分布を表現するというよりも、パーティクルフィルタみたいなイメージが先に去来します。

 最近の言語モデルでも、Reasoningなしでは解けないような難しい問題に対して、かなり長大なChain of Thoughtをして最終的に回答を出すということは多く見られると思います。その過程は必ずしも直線的な思考だけではなく、様々な方針を考えて検証して、というステップが入っているでしょう。となると結局、特別な工夫がそれほどあるわけではない自己回帰出力の中で、ある程度不確実性の維持やその解消というものが行われているのかもしれません。

 我々が自分の内面を反省したり、他の人の創作過程のインタビューを見聞きした結果得られる洞察として、不確実性の維持や解消という過程があること自体は正しいのでしょうが、それをどこまで明示的な仕組みとして実装しにいくべきなのかは悩ましいところです。データが多ければ素朴なTransformerで多くの振る舞いが実現できるのかもしれませんが、一方で計算資源やデータ量の問題でそれをできない研究者としては、バイアスが乗ってしまうことを受け入れつつ、考えたダイナミクスを実装していくしかないような気もします。

内省の認知動力学:創造性/精神病理/プロジェクションの計算論的理解に向けて

 このセッションでは、内省という行為を"自己の認知を変容させる内的行動"として捉えつつ、広くは自由エネルギー原理とも関連するものとして、単一目的関数の最適化から様々な認知的振る舞いが説明可能なのではないかという考え方が話されていました。

 内省という行為を一種の行動としてちゃんと考えることは重要そうに感じます。そう定式化してしまえば、一応強化学習の枠組みには乗るので、良い内省を出力するように言語モデルをパラメータ更新していく余地自体は生まれると思われます。本当にそれで上手く学習できるかというと実践的には大変そうですが。

 Chain of Thoughtを内省と見なすこととすると、その効果がどこまで大きいのかが重要になってきます。To CoT or not to CoT? Chain-of-thought helps mainly on math and symbolic reasoningという論文では、結局CoTが有用なのは主に数学・記号的推論の問題に限られるとも言われており、多方面での活用にはまだ課題もありそうです。一方、直観的にはなにか良い活用方法がなにかあるのではと思われます。

 そもそもロボットなどでのタスクではあまり長時間動作を止めて考え続けるのも微妙ではあるのですが、先に書いた非同期動作なども検討しつつ、CoT(あるいはより広く言語を使った認識の強化)の恩恵を探っていきたいところです。

ポスト学習時代の認知科学:汎化可能な学びの展開

 このセッションでは、深層学習によって一部の"学習"については性能が良いものが得られており、理解、洞察、創造性などの次のステップを考える講演が行われていました。

 今井むつみ先生の講演で特に強調されていましたが、一つの事例から過剰に一般化しようとするバイアスがまだ人工知能では弱いのではないかという意見には一定納得できるものがあります。結局、言語モデルの性能自体は高いかもしれませんが、学習する能力という意味では高いのかどうかよくわかりません。少なくともパラメータを凍結して運用している状態では、学習能力なんて一切ないとも言えます。

 過剰に目の前のルールを適用しようとする振る舞いとして考えると、In-Context学習は近いものがあるかもしれません。先に示したルールやテキストに強く束縛されて出力も決まっていくということです。ただこれも「全体」を考えて広く適用しているのではなく、単に即応的な振る舞いという印象も受けます。両者の区別は本当にできるものなのかは怪しいかもしれませんが。

 こうした振る舞いはかなり複雑に見えるので、素朴なレベルでパラメータ最適化を考えると、それほど複雑な振る舞いが創発することはないのでは、なにか特殊な仕組みが必要なのではと思ってしまうところもあります。一方で、超巨大なネットワークだとそういう素朴な直観というのは上手く当たらないのだろうなとも思われます。

 基本的には、やはり最も上手くいっているニューラルネットワークのことを参考にして、あまり特別な機構を手組みしていくのではなく、スケール性を阻害しないようにするという意識で取り組むのが大事なのかなとは感じました。

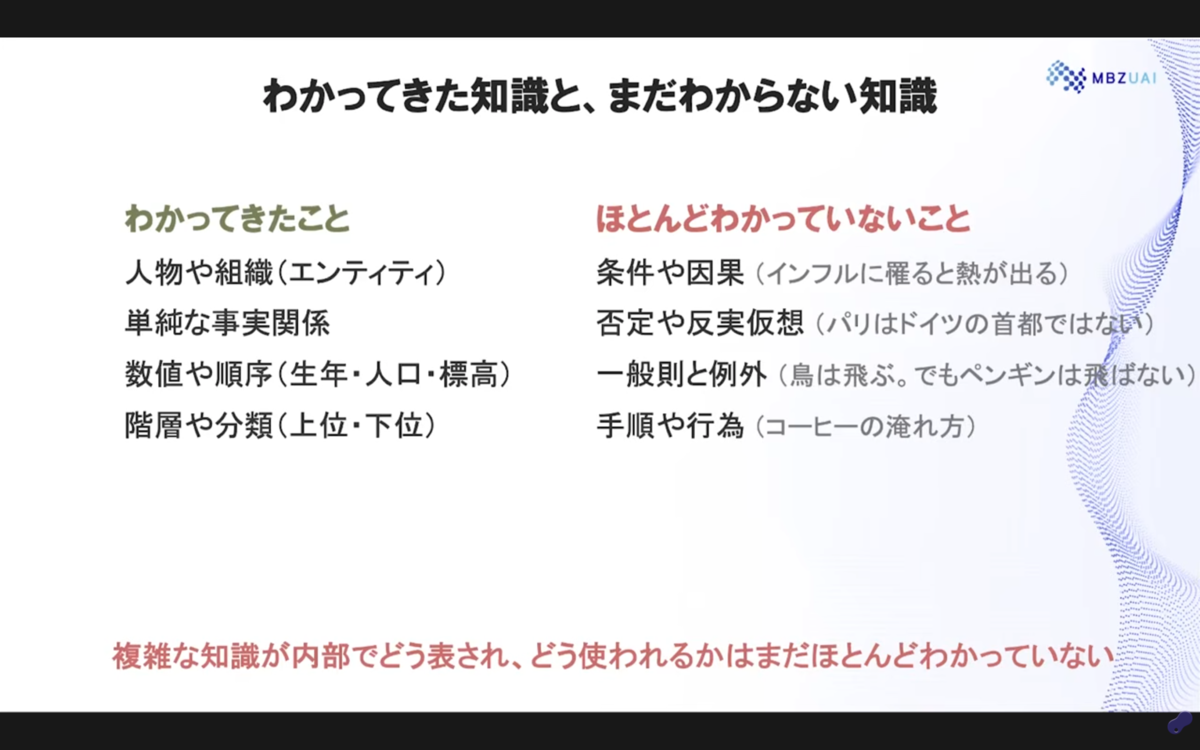
 JCSSとは関係ない動画ですが、【第102回】大学等におけるオンライン教育とデジタル変革に関するサイバーシンポジウムにおける「LLMは何をどのように記憶しているか」乾 健太郎では、LLMの内部状態(活性値)などの研究から、現段階では

と整理されており、こういうアプローチを進めていくのが重要なのかなと感じます。

総括

 ロボティクスと認知科学の交点の一つとして、CoT・あるいはテキスト生成を活かしたVLAというのは一つ重要なテーマになってくると思うので、そこでなんとか成果を出していきたいと感じました。

AnimalAIデータ調査

 900シナリオから最初のバリアントだけ(つまり300通り)を自分でプレイしたので、いくつか気になることをメモします。

前提

 今までTrainデータが別途分かれていていると思っていましたが、確認してみると結局同一のようでした。

 よって、この評価データと思っていたコンペティションのバリアント01系をプレイしました。

難易度所感

 基本的には全てギミックは一目でわかり、理解の問題で解けないというものはなさそうでした。加速度の制御的に操作性が難しいところはあるのと、微妙なミスで溶岩に触れて即終了とかは少しありましたが、認知的には解けてほしいところです。

 一方で、一番難しいタスクまでの難易度勾配が十分になだらかであるかというと確信は持ちきれないところもあるため、このタスクセットだけをやっていて、認知的な能力がゼロに近いところから育てられるかは怪しい気もします。

 特に物体の移動については

 300件のシナリオの簡単な説明はスプレッドシートに書きました: https://docs.google.com/spreadsheets/d/1Hvpjj3PL3SHCfVK6sEB1QW1EOYjAaCFXcXkYoUbcnCo/edit?usp=sharing

問題がありそうなもの

 いくつか問題がありそうなものは見つかったので記録します。使用バイナリはv4.3.2です。

(1) 02-27-01: バグっぽい挙動でなにもしなくてもクリアになる

 02-27-01は以下のようなシナリオです。

 青い線は段差になっており、反対側にはいけません。これは左下に初期化されるエージェントが、行けない反対側にある黄色い玉は無視し、右下の緑色の玉に向かうことを要求しているタスクです。

 問題であるのは、黄色い玉が横方向についてはランダムな配置になっているのですが、ランダム性によってはこの幅に5個の玉が置ききれない状況が発生し、その際はプログラムの様々な都合によりほぼバグ的な挙動でちょうどエージェントの真上に黄色い玉が生成されます。それが重力によって降ってきてエージェントが正の大きな報酬を獲得し、そこで即クリアとなってしまいます。

 対策として、ランダムではなく等間隔に配置するようにしました。

(2) 04-22-01/02/03: 足場が低すぎて溶岩を抜けられない

 このシナリオは以下のgif動画の通り、溶岩地帯を足場で回避することが想定されたものだと思われますが、足場が低すぎて乗っても溶岩により失敗判定となってしまいます。

 おそらくAnimal-AIのバージョン変更で、溶岩の最低高さなどが変更された影響だと思われます。

 対策として、足場をもう少し高くするようにしました。

(3) 08-29-*, 08-30-* において玉が溶岩地帯の中に留まってしまう

 このシナリオでは、報酬をもつ緑色の玉が転がっていき、先端の方で左右どちらかに跳ね返るのでそれを見て適切な方に降りていくことを求めているタスクです。

 しかし、柱との位置関係の影響で柱に引っかかって溶岩地帯から出ないため、玉に触ることが不可能になっています。

 対策として、もう少し柱を外側に配置することで、玉が止まる位置が溶岩地帯の外側になるようにしました。


 以上3点の修正を入れて、ほぼ300点(おそらくバリアントも含めて900シナリオ)がクリア可能になったと思われます。

 作業においていくらかClaude Codeを使った箇所もあり、Claudeがスクリーンショットを撮って状況を把握することなどはそこそこできていたように感じるため、最近のVLMであば一定状況の把握はできるのではないかという予感がします。

 実践的に自分のマシンで動かせるような小さいモデルでは性能が十分ではないかもしれませんし、このAnimal AI環境に慣れていくという面を強化学習で実現するのかハーネス的なものの方が効率良いのかなどはいろいろありそうですが、ゼロから複雑な認知を学習させるよりは希望があるのかなと。今後もまだしばらくそのあたりを触ってみようと思います。

AnimalAI(その4)コンペティション1位解法の仮再現

 前回に調べた通り、Animal AIは2019年にコンペティションが行われていました。

 その1位解法はGitHubで公開されています。

 まずAnimal AIのバイナリがv1であり、最新のv4からすると古いため、これを更新することを試みました。しかし、最新のv4では見た目が変わっているため、学習済みモデルをそのまま適用すると成功率が下がります。

条件 900シナリオでの成功率
v1バイナリ + 公開されている学習済みネットワーク 44.8%
v4バイナリ + 公開されている学習済みネットワーク 17.4%

 よって、学習側全体をTensorFlow→PyTorchに置き換え、学習し直せるようにしました。

 また学習データとしても、元々はコンペティション前に作業されていたものであるため自作のシナリオが使用されていましたが、今後平等な設定で実験していくために、Animal-AIの学習データとして使われていたaai3-paper-experiments/tree/master/ppo/aai/configs/paperをこちらでも使うように変更しました。

学習データの量と性能の関係

 学習データは評価タスクと同じ10カテゴリに分類されています。カテゴリは論文のTable 2に対応しています。

カテゴリ 内容
1 Food Retrieval 障害物のない空間に置かれた餌を取る
2 Preferences 複数の選択肢から良い方を選ぶ
3 Static Obstacles 壁などに遮られた餌に回り込む
4 Avoidance 溶岩などの負の領域を避けて到達する
5 Spatial Reasoning 坂や台を使って高所の餌に進む
6 Generalisation 1〜5と同じ課題を、色などの見た目を変えて出題
7 Internal Modelling 途中で暗転する
8 Object Permanence 餌が物陰に隠れる
9 Numerosity 量や大きさの異なる選択肢から最大を選ぶ
10 Causal Reasoning 可動物体に働きかけないと餌に届かない

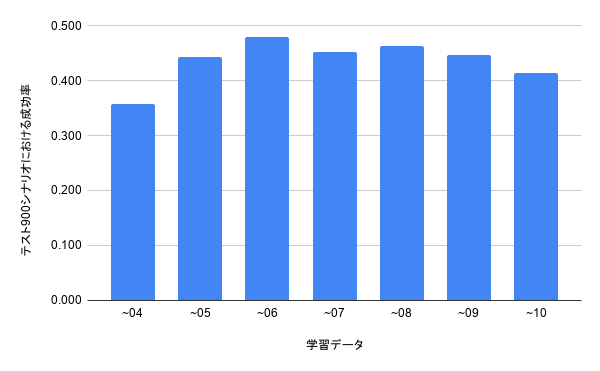
 ここではカリキュラム学習こそしませんが、カテゴリ1からどこまで含めて学習すれば最も良い性能になるのかを調査しました。学習条件はすべて共通で、24並列 × 256ステップ × 2500エポック = 約1536万ステップ、1本あたり約3.8時間です。評価はコンペティションでの900シナリオを使っています。

 結果としては、見える壁の色のランダム性が生じるカテゴリ6を含むタイミングで最も高い成功率となりました。カテゴリ10あたりは難しいため学習には良い影響を与えないようですが、ものすごく大きな性能低下ではないのでわかりやすく学習データを全部使うカテゴリ10までの採用としたいと思います。

評価結果の一例

 採用することにした、カテゴリ10まですべてを学習データとした場合の内訳です。

カテゴリ 成功率 平均報酬
全体 41.3% (372/900) 0.944
1 Food Retrieval 84.4% 2.951
2 Preferences 58.9% 1.298
3 Static Obstacles 26.7% -0.571
4 Avoidance 28.9% -0.357
5 Spatial Reasoning 45.6% 1.050
6 Generalisation 55.6% 0.997
7 Internal Modelling 81.1% 1.238
8 Object Permanence 30.0% 0.072
9 Numerosity 1.1% 3.771
10 Causal Reasoning 1.1% -1.013

 全体では41.3%で、冒頭に挙げた「v1バイナリ + 公開されている学習済みネットワーク」の44.8%にはわずかに届いていません。バイナリも学習データも変わっているので単純な比較は不適切ですが、移植と再学習が機能していることの一応の確認にはなります。

今後

 まずこの手法では24並列でエージェントと環境を動かして軌跡を収集してPPOを行います。実際の動物では1個体1環境であると考えられるため、そこに対するアプローチを検討したいところです。

 また、カテゴリ9,10は成功率が低いため、このあたりの高度な判断が必要とされるタスクで改善できる手法が作れると良いと思われます。